Örneğin eğitim taramasını istemeyip ChatGPT aramasına açık kalabilirsiniz. Fakat “GPTBot'u kapattım, artık hiçbir AI ürününde görünmem” sonucu çıkarılamaz. Aynı şekilde bir arama botuna izin vermek de sayfanızın kaynak seçileceğini garanti etmez. Görünürlük tarafındaki diğer kontroller AI araması için sayfa denetiminde yer alıyor.
robots.txt Nerede Durur ve Hangi Kurallar Uygulanır?
Dosya ilgili sitenin kökünde, örneğin https://example.com/robots.txt adresinde bulunur. Alt alan adı, protokol veya port değiştiğinde kapsam da değişebilir; yalnız ana sitenin dosyasını düzenleyip bütün alt alan adlarını yönettiğinizi varsaymayın.
User-agent, kural grubunun hangi tarayıcıya hitap ettiğini belirtir.Disallow: /, bu gruba uyan tarayıcıdan bütün yolları taramamasını ister.Disallow: /arsiv/, yalnız o yolun altını kapsar.Allow, desteklenen eşleştirme kurallarına göre bir istisna tanımlar.User-agent: *, özel bir eşleşme olmadığında kullanılan genel gruptur.
Robots Exclusion Protocol standardında kurallar erişim yetkilendirmesi sayılmaz. Standart kurallara uyan bir bot, kendisine özel eşleşme bulamazsa yıldız grubuna bakar; bu yüzden “adı yazmıyorsa her yere serbestçe girer” demek yanlıştır. Google'ın uygulama belgesi de özel grubun genel grubun kurallarını otomatik devralmadığını açıklar.
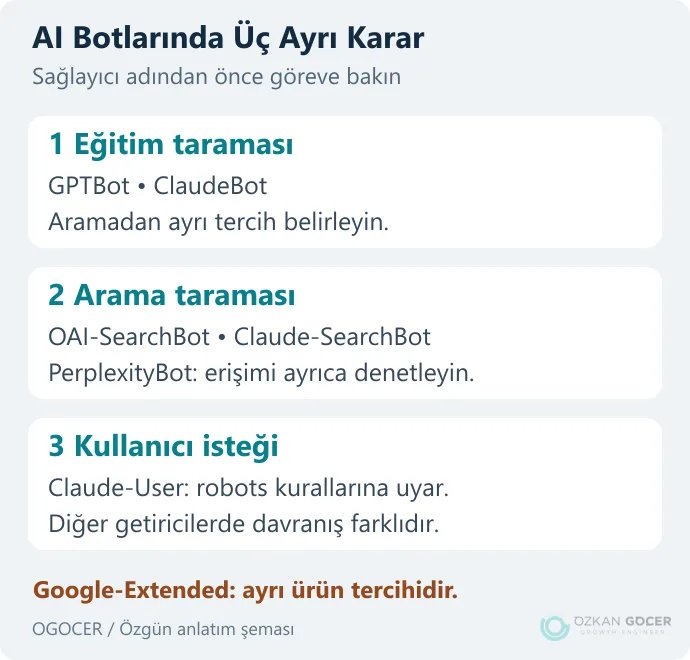
Hangi Bot Hangi İşi Yapıyor?
Tüm sütunlar için tabloyu yana kaydırın. Klavyeyle tabloya odaklanıp ok tuşlarını kullanabilirsiniz.
| Ad | Belgelenen Görev | Karar Verirken Dikkat |
|---|---|---|
| GPTBot | OpenAI model eğitimi için tarama | OAI-SearchBot'tan ayrı ayarlanır. |
| OAI-SearchBot | ChatGPT araması | İzin, gösterilme garantisi değildir. |
| ChatGPT-User | Kullanıcının başlattığı sayfa isteği | OpenAI, robots kurallarının uygulanmayabileceğini belirtir. |
| ClaudeBot | Model geliştirme/eğitim taraması | Claude-SearchBot ve Claude-User'dan ayrıdır. |
| Claude-SearchBot / Claude-User | Sırasıyla arama / kullanıcı isteği | Anthropic her ikisinin de robots kurallarına uyduğunu söyler. |
| PerplexityBot | Perplexity araması için tarama | Sağlayıcı bunu temel model eğitimi taraması olarak tanımlamaz. |
| Perplexity-User | Kullanıcının başlattığı getirme | Sağlayıcıya göre robots kurallarını genellikle uygulamaz. |
| Google-Extended | Belirli Gemini/Vertex eğitim ve kaynaklandırma kullanımları için tercih | Ayrı HTTP bot adı değildir; Google Arama sıralama sinyali değildir. |
Adlar ve görevler OpenAI, Anthropic, Perplexity ve Google'ın güncel belgelerinden kontrol edildi. Kullanıcı isteğiyle erişen botların hepsini aynı kabul etmeyin: Claude-User için açıklanan davranış, ChatGPT-User veya Perplexity-User ile aynı değildir.
Eğitim Taramasını Kapatıp Aramayı Açık Tutma Örneği
Aşağıdaki blok tam bir robots.txt dosyası değildir. GPTBot ve ClaudeBot için eğitim taramasını istemeyen bir sitenin mevcut kurallarına eklenecek örnektir. Dosyanızda aynı botların zaten bulunduğu gruplar varsa kuralları birlikte inceleyin; ikinci, çelişkili bir kopya bırakmayın.
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /
Bu örnek OAI-SearchBot, Claude-SearchBot ve PerplexityBot için yeni izin vermez veya mevcut engeli kaldırmaz. Arama botları için yürürlükteki özel grubu, yoksa * grubunu ve sunucu güvenlik kurallarını ayrıca kontrol edin. Mevcut genel grupta Disallow: / varsa yalnız yukarıdaki satırları eklemek aramayı açmaz.
Google-Extended hakkında ayrıca karar verin. Token yalnız eğitim anlamına gelmez; belgede Gemini/Vertex tarafındaki grounding, yani yanıtı web kaynaklarıyla destekleme kullanımı da kapsamda. Bunu sınırlamak istiyorsanız aşağıdaki grup ayrı bir tercih olarak değerlendirilebilir:
User-agent: Google-Extended
Disallow: /
Yeni bir kural, daha önce toplanmış verinin veya eğitilmiş modeldeki bilginin geriye dönük silindiğini kanıtlamaz. Tarama tercihini veri silme işlemi gibi sunmayın.
Özel Bot Grubu Genel Kısıtlamaları Devralmaz
En kolay gözden kaçan hata, arama botunu açarken mevcut yol kısıtlarını kaybetmektir. Aşağıdaki yanlış örnekte /arsiv/ kısıtının OAI-SearchBot'a da uygulanacağını sanabilirsiniz:
# Yanlis varsayim: ozel grup, * grubunu devralmaz
User-agent: *
Disallow: /arsiv/

User-agent: OAI-SearchBot
Allow: /
OAI-SearchBot için özel grup tanımlamanız gerekiyorsa, korunacak tarama kısıtını o grubun içinde de belirtin. Şu örnekte iki grup için aynı yol kapalıdır:
User-agent: *
Disallow: /arsiv/

User-agent: OAI-SearchBot
Disallow: /arsiv/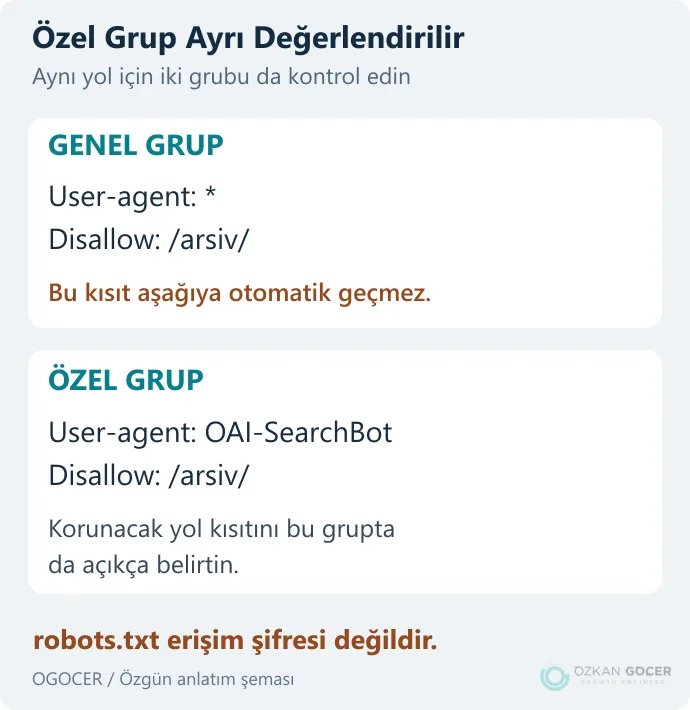
Buradaki yol yalnız bir tarama örneğidir. Gizli dosya veya yönetim paneli varsa oturum, yetki ve sunucu erişim kontrolleri kullanın. Dosyaya hassas yolları yazmak onları gizlemez; robots.txt herkese açık okunabilir.
Google AI Bakışı ve AI Modu Nasıl Ayrı Yönetilir?
Google-Extended ayarı, Google Arama'ya dahil olmayı veya sıralamayı yönetmez. Googlebot'u bütünüyle engellemek ise normal arama taramasını da etkiler. Yalnız üretken Arama özelliklerinden çıkmak isteyen site sahibi için güncel seçenek, Search Console'daki Search generative AI tercihidir.
Google'ın bu ayara ilişkin belgesi, üretken özelliklerden hariç tutmanın diğer Arama sonuçlarına dahil olmayı veya sıralamayı etkilemediğini; tercihin model eğitimi kontrolünden ayrı olduğunu açıklar. Üst mülkten devralınan ayarı da kontrol edin.
nosnippet, max-snippet ve data-nosnippet gibi önizleme kontrolleri farklı bir katmandır: normal aramadaki önizlemeyi de etkileyebilir. Küçük bir snippet sınırını “bütün AI kullanımlarından çıkış” saymayın. Ürünlerin ne gösterdiği için Google AI Modu rehberi, genel indeksleme sorunları için teknik SEO rehberi ayrı devam yollarıdır.
Yayınlamadan ve Yayınladıktan Sonra Nasıl Kontrol Edilir?
- Mevcut dosyayı yedekleyin. Değişen satırları, amacı ve geri dönüş dosyasını kaydedin.
- Bot ve yol çiftleri yazın. Örneğin OAI-SearchBot + açık makale yolu izinli; aynı bot + kısıtlanan arşiv yolu yasak. Her hedef için beklenen sonucu belirtin.
- Gerçek adresteki dosyayı okuyun. Sunucudaki ve CDN'deki sürümün doğru olduğunu kontrol edin. Yönetim panelindeki metin ile dışarıya dönen dosya farklı olabilir.
- HTTP ve güvenlik yanıtını ayrı inceleyin. Robots izni olsa bile 403, 429 veya doğrulama ekranı erişimi engelleyebilir.
- Sonraki taramaları izleyin. Güncel sağlayıcı doğrulama yöntemleriyle bot kimliğini kontrol edin. User-Agent başlığı tek başına kimlik kanıtı değildir.
Kendi sitenizin dosyasını indirmek ve yanıt başlıklarını görmek için salt okunur örnek komut:
curl -i https://example.com/robots.txtBu komutta example.com yerine kendi alan adınızı yazın. Bir User-Agent taklit ederek gönderdiğiniz isteğin başarılı olması, sağlayıcının gerçek IP'sinden gelen botun da geçeceğini kanıtlamaz. Tersine, robots dosyasını okuyabilmek de makale yolunun veya kaynak seçiminin doğru olduğunu göstermez.
Son Kararı Bir İzin Tablosuna Yazın
Her sağlayıcı için “eğitim”, “arama” ve “kullanıcı isteği” satırlarını ayrı tutun. Yanına kararın gerekçesini, değişiklik tarihini ve kontrol sonucunu ekleyin. Bir tercih değiştiğinde ilgili grubu güncellemek, aylar sonra hangi satırın neden yazıldığını tahmin etmekten daha güvenilirdir.
Tarama tercihi için robots.txt, gerçek erişim denetimi için sunucu kontrolleri, indeks ve önizleme için ürünün kendi araçları gerekir. Bu üçü ayrı incelendiğinde hem istemediğiniz kullanımı daha açık tarif eder hem korumak istediğiniz arama erişimini yanlışlıkla kapatma riskini azaltırsınız.